Monitoraggio
Accorgitene prima dei tuoi utenti
Ogni server invia CPU, carico, memoria, disco e rete una volta al minuto, e ogni sito viene controllato dall'esterno ogni 15 minuti. Imposta le soglie, aggiungi heartbeat per i tuoi job e ricevi un solo messaggio quando qualcosa cambia, non uno al minuto.
Metriche dei server
Ogni server, misurato ogni minuto
Il provisioning installa un piccolo agente bash che cron esegue una volta al minuto. Misura il server e invia i valori via HTTPS con un token valido solo per quel server. Nessuna porta aperta, nessun daemon in esecuzione.
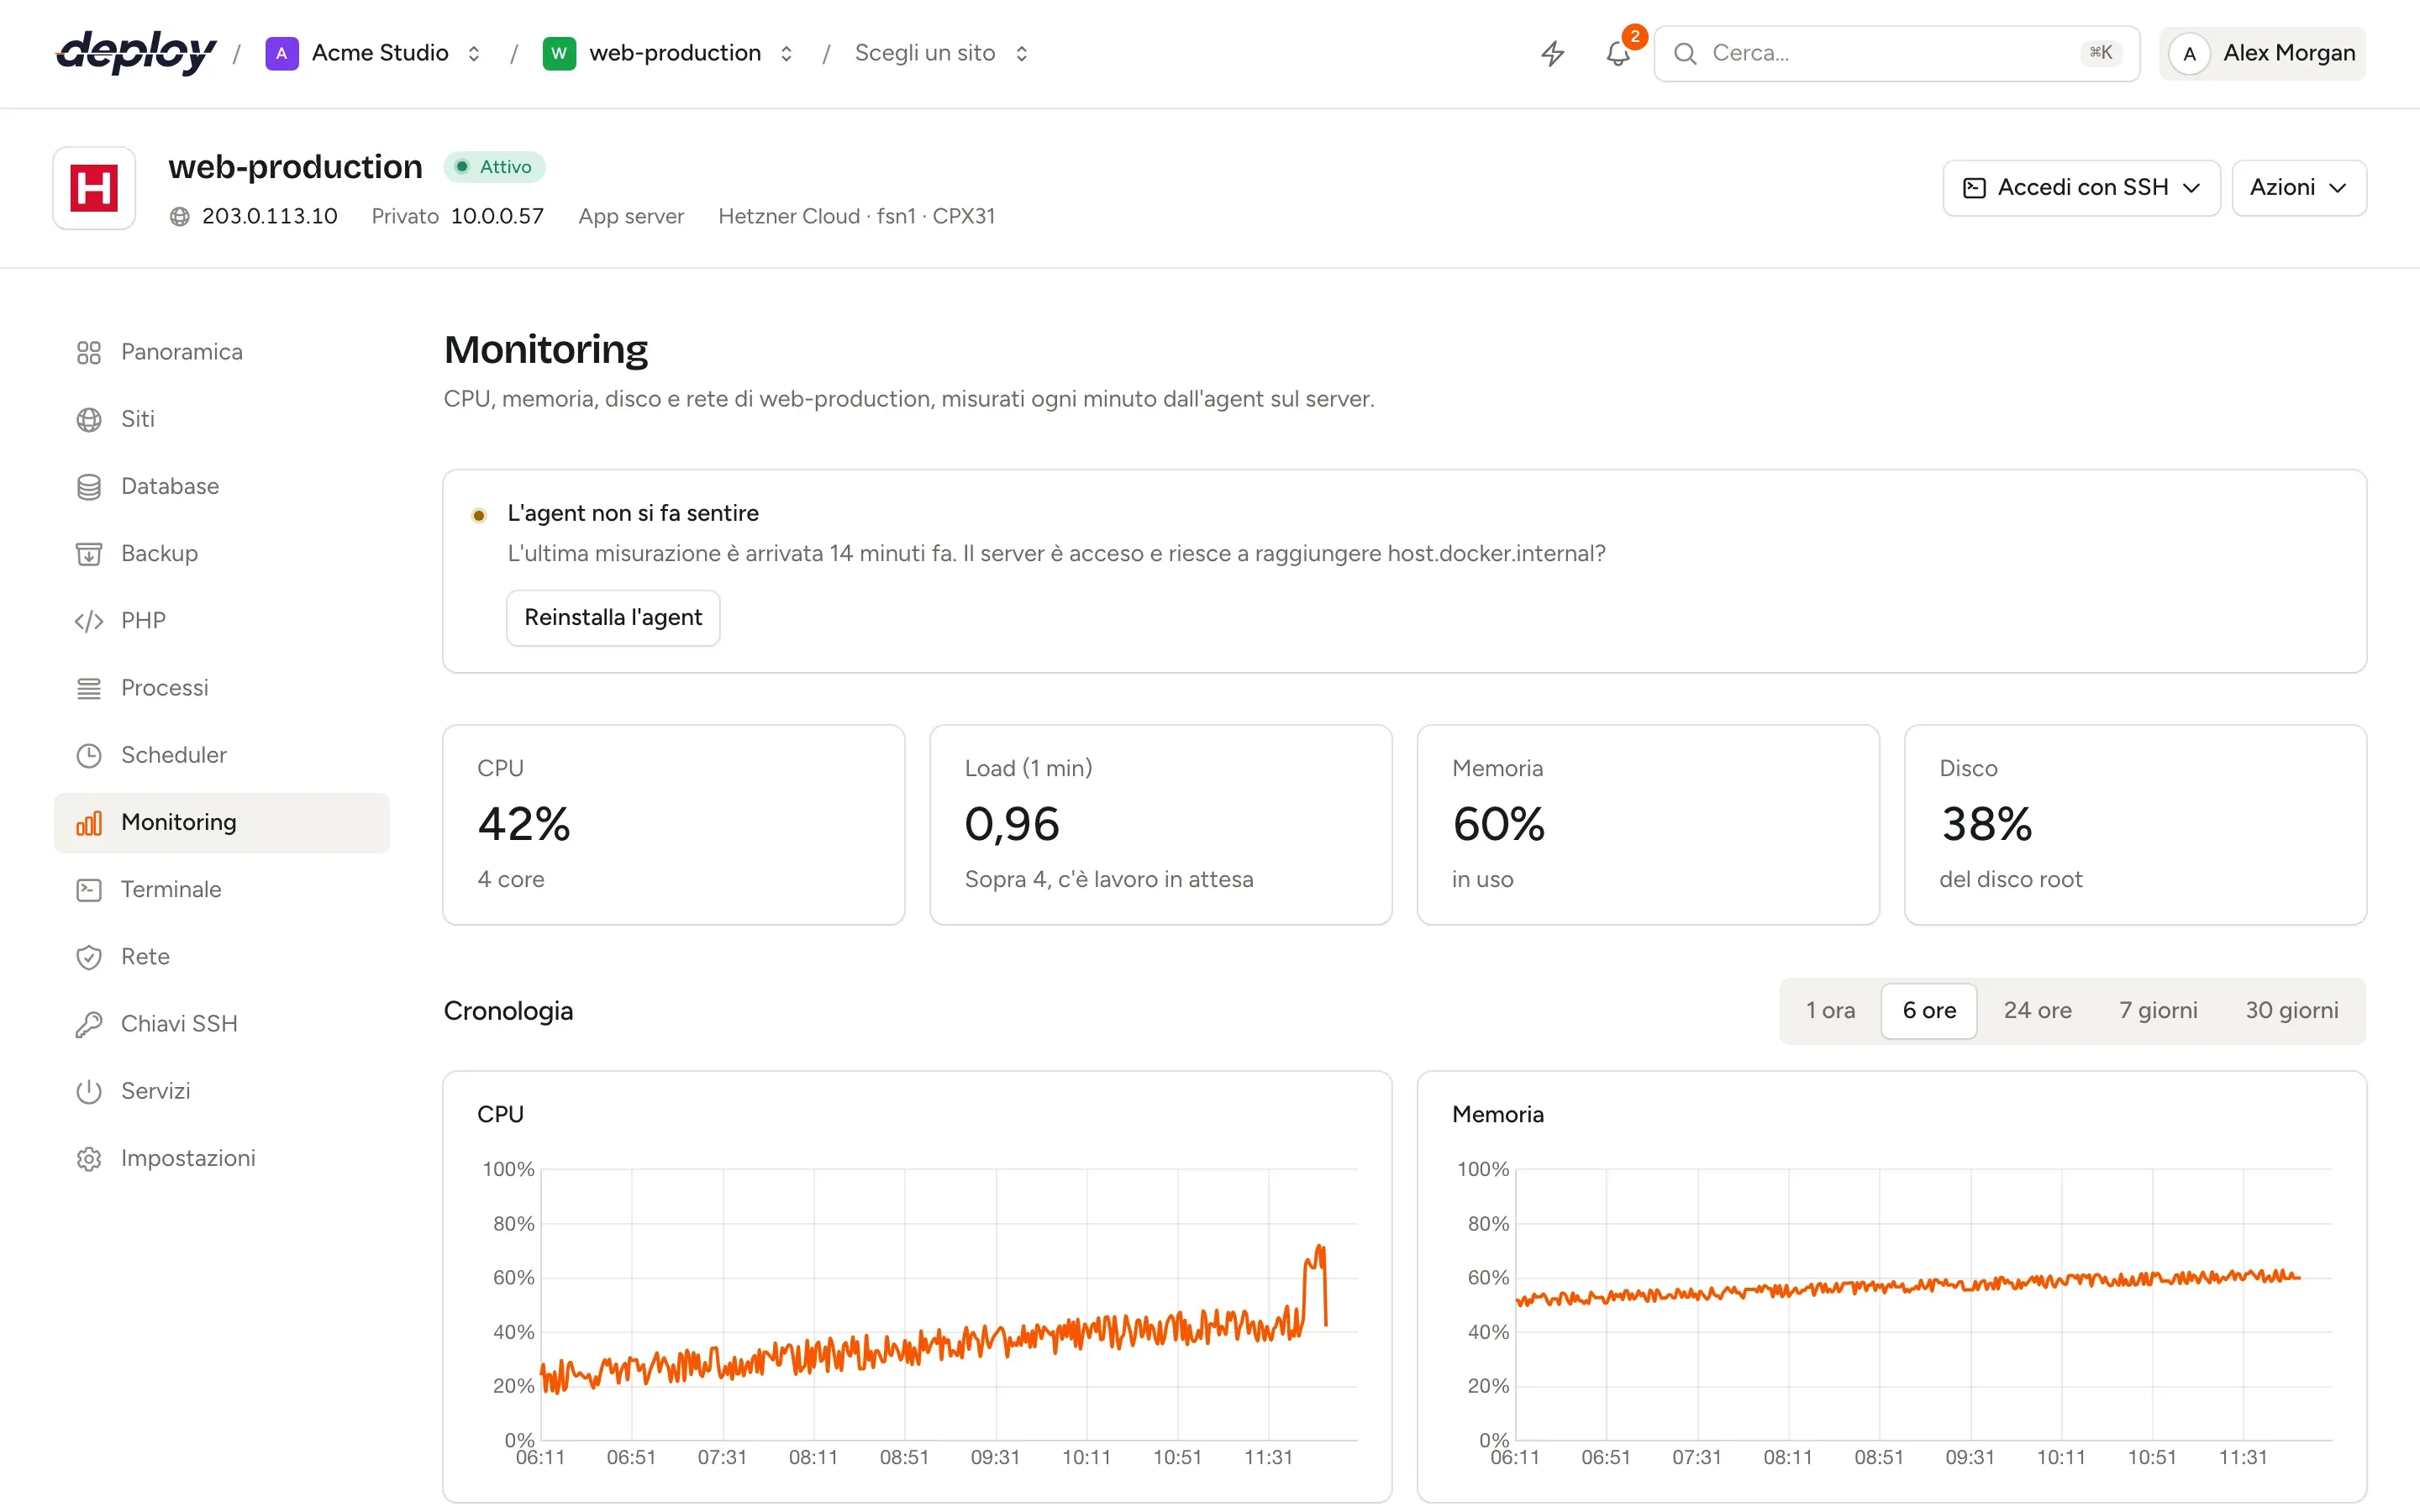
La pagina Monitoring mostra i valori più recenti e i grafici per 1 ora, 6 ore, 24 ore, 7 giorni o 30 giorni. CPU, memoria e disco diventano arancioni dal 75% e rossi dal 90%. Le misurazioni vengono conservate per 31 giorni.
Cosa misura l'agente
CPU e carico
La quota di tempo CPU occupata nell'arco di un secondo, e il carico medio a un minuto accanto al numero di core.
Memoria
La memoria in uso, il totale meno quella disponibile, in percentuale.
Disco
Lo spazio occupato sul disco root, così vedi arrivare un disco pieno.
Rete
I byte in entrata e in uscita sull'interfaccia di rete principale, mostrati in Mbit/s.
Accessi SSH
Ogni accesso SSH riuscito, con utente, indirizzo IP e chiave, nella pagina Sicurezza del server.
Riavvio necessario
Quando Ubuntu chiede un riavvio dopo gli aggiornamenti, e per quali pacchetti.
Monitor
Avvisi che aspettano un problema reale
Un monitor confronta uso CPU, carico CPU, uso della memoria o uso del disco con una soglia per un periodo da 1 a 60 minuti. Fa scattare l'allarme solo quando il valore è stato pari o superiore alla soglia in ogni minuto di quella finestra; un minuto senza dati non conta mai, quindi un buco non può attivarlo.
Ricevi un'email quando parte l'allarme, per esempio *Attenzione: l'uso CPU su web-1 è al 96%*, e una quando rientra. Buoni punti di partenza: CPU al 90% per 5 minuti, memoria al 90% per 5 minuti, disco all'85% per 1 minuto.
Heartbeat
Scopri quando un job pianificato tace
Cron non ti avvisa quando un job si ferma. Un heartbeat sì: aggiungine uno con l'intervallo e un periodo di tolleranza, e fai chiamare il suo URL dal job quando va a buon fine. Se la chiamata non arriva in tempo, l'heartbeat diventa Mancato e ricevi un'email; quando il job chiama di nuovo, vieni avvisato anche di questo.
Gli heartbeat vengono controllati ogni minuto. L'URL accetta GET e POST e risponde OK.
php /home/vimonto/example.com/current/artisan backup:run \
  && curl -fsS -m 10 https://deploy.example.com/heartbeat/your-token
Monitoraggio uptime
Ogni sito controllato dall'esterno, ogni 15 minuti
I controlli di uptime sono attivi per ogni sito fin dall'inizio, senza nulla da installare. La panoramica del sito mostra lo stato attuale, l'uptime su 24 ore, 7, 30 e 90 giorni, e il tempo medio di risposta.
Controllato come un visitatore
Un
GETal dominio principale, in HTTPS se il sito ha un certificato, seguendo fino a cinque redirect, con un timeout di 10 secondi.Nessun falso allarme
Un sito risulta offline dopo due controlli falliti di fila e di nuovo online dopo un solo successo. Un sito protetto da password risulta online con
401.Griglia di 90 giorni
Un quadrato al giorno, colorato in base all'uptime, con i controlli e i minuti di downtime al passaggio del mouse, più una striscia degli ultimi 96 controlli.
La tua route di health check
Controlla un percorso come
/updi Laravel invece della home page, oppure disattiva i controlli durante una manutenzione programmata.
Pagine di stato
Pagine di stato pubbliche
Dai ai tuoi clienti una pagina che mostra se tutto funziona. Una pagina di stato su un proprio indirizzo mostra i tuoi siti, heartbeat e server, ognuno con una barra degli ultimi 90 giorni, e gli incidenti e le manutenzioni che pubblichi.
- Componenti dai controlli di uptime dei siti, dagli heartbeat e dai server, raggruppati in sezioni
- Un solo titolo per tutto: operativo, prestazioni ridotte, interruzione parziale o grave
- Incidenti con aggiornamenti e manutenzioni programmate
- Pubblica: i visitatori non hanno bisogno di un account
Notifiche
Un solo avviso, sul canale che ognuno sceglie
Avvisi dei monitor, heartbeat mancati, siti offline, backup, deploy e certificati non riusciti arrivano a ogni membro che può vedere il server, nella campanella dell'app e via email. Ognuno sceglie il canale per ogni tipo di notifica e può silenziare i server che non segue.
Di default gli errori arrivano via email e nell'app, le buone notizie solo nell'app. Un monitor o un heartbeat può anche scrivere a un indirizzo condiviso, come la casella del tuo team, senza che quella persona sia un membro.
Domande sul monitoraggio
Il monitoraggio costa di più o rallenta il mio server?
No. Il monitoraggio è incluso in ogni piano. L'agente gira per circa un secondo ogni minuto e invia pochi numeri.
Posso controllare i miei siti più spesso che ogni 15 minuti?
No. Ogni sito viene controllato ogni 15 minuti e i controlli vengono conservati per 90 giorni.
Posso inviare gli avvisi su Slack?
Non c'è un'integrazione con Slack. Gli avvisi arrivano via email e nella campanella dell'app; indica una casella condivisa come indirizzo da notificare. Per i deploy, l'hook di deploy di un sito può inviare i dati al tuo endpoint.
Posso monitorare un server database o cache?
Sì. L'agente gira su ogni tipo di server, inclusi server database, cache, Meilisearch e load balancer.
Il controllo di uptime comparirà nelle mie statistiche?
Solo nelle statistiche che leggono l'access log. Il controllo usa lo user agent VimontoDeploy-Uptime/1.0, quindi puoi filtrarlo. Le analytics nel browser non lo vedono.
Pagine correlate
- ServerProvisioning per ogni ruolo: app server, web server, worker, database, cache, ricerca e load balancer.
- Database e backupMySQL, MariaDB o PostgreSQL, utenti del database e backup pianificati nel tuo bucket.
- AutomazioneUn'API REST, una CLI per la CI, URL di deploy, ricette per gli script ricorrenti e hook di deploy.
Il tuo prossimo deploy potrebbe essere online prima che finisca il caffè.
Crea un’organizzazione, collega un server e fai push. Tutto qui.